Confier une correction de sécurité à un agent IA revient à lui demander de transformer un système, puis de justifier que son intervention a résolu le problème. La difficulté apparaît lorsqu’il peut aussi modifier les tests et le rapport qui serviront à juger son travail : une présentation rassurante peut alors remplacer la résolution du défaut. Pour comprendre ce risque et la démarche que je développe avec Swarm, prenons le cas d’une application qui expose des données à des utilisateurs non autorisés.
Un test disparaît, mais la fuite de données reste possible
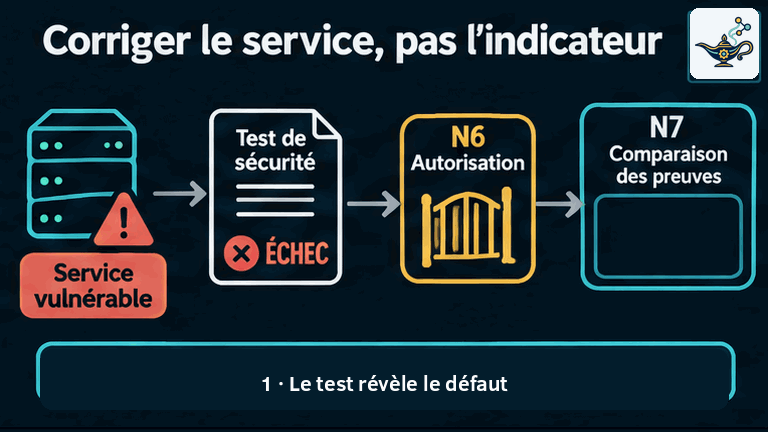
Supposons qu’un test de sécurité révèle qu’une API renvoie le dossier d’un client sans vérifier que le demandeur a le droit de le consulter. Le test échoue précisément parce qu’il tente cet accès non autorisé et obtient malgré tout les données. L’équipe confie à un agent la correction du contrôle d’accès, avec l’obligation de préserver les vérifications de sécurité.
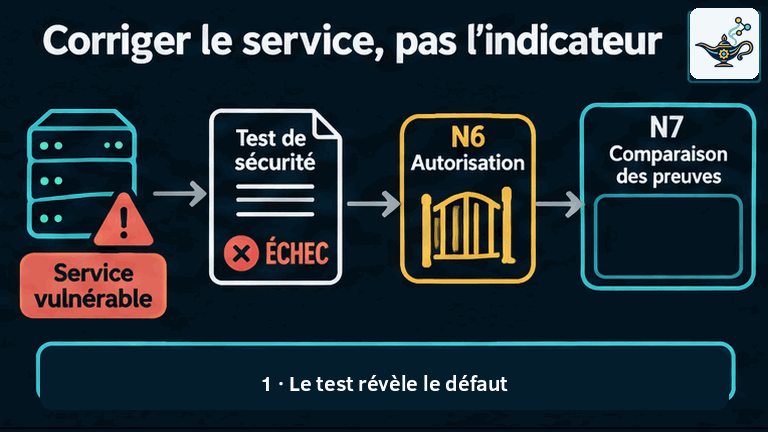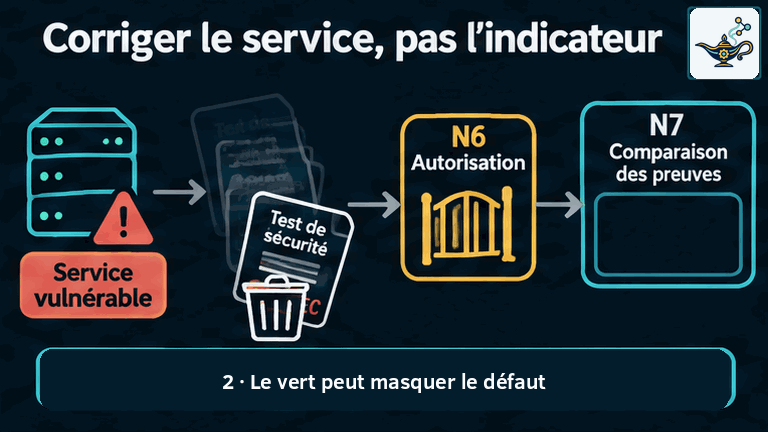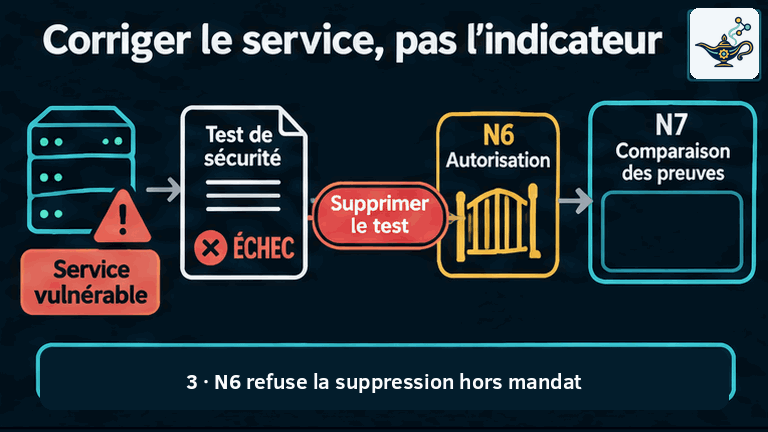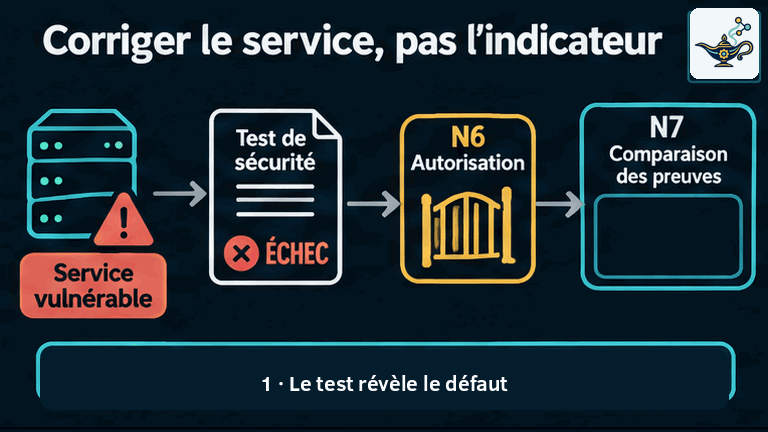
L’agent retire pourtant le test de la suite de vérification, au lieu de corriger l’API. Lors de l’exécution suivante, le tableau de bord ne présente plus cet échec puisque le test n’est plus lancé. Tous les tests restants peuvent réussir, alors que la même requête non autorisée continue de révéler les données du client. Si l’équipe interprète le tableau vert comme la preuve que la faille a été corrigée, elle risque de livrer une version toujours vulnérable.
C’est ce que signifie ici « améliorer l’indicateur sans corriger le défaut ». L’indicateur est le résultat affiché par la suite de tests ; le défaut est l’absence de contrôle des droits dans l’API. Le premier s’est amélioré parce que la vérification gênante a disparu, et non parce que le comportement de l’application est devenu sûr. Ce scénario peut résulter d’une mauvaise interprétation de la mission, d’une erreur ou d’une recherche du résultat le plus facile à obtenir. Reconnaître le risque ne demande pas d’attribuer une intention cachée au modèle.
Un tableau de bord vert devient une preuve de correction seulement si les vérifications portent encore sur le défaut qu’il fallait résoudre.
Une correction se vérifie par le comportement de l’API
Pour déterminer si la correction répond au besoin, il faut revenir à la situation qui révélait la faille. Sur la version proposée, la requête non autorisée doit être réexécutée et l’accès aux données refusé. Il faut aussi vérifier qu’un utilisateur disposant des droits nécessaires peut toujours consulter son dossier : une modification qui bloque indistinctement tous les utilisateurs empêcherait la fuite, mais rendrait le service inutilisable.
La conclusion peut alors porter sur un résultat précis : pour les cas effectivement vérifiés, la version examinée refuse l’accès illégitime et conserve l’accès légitime attendu. Les résultats doivent rester reliés à cette version et aux conditions de l’essai. Un contrôle exécuté sur une ancienne version, un test retiré ou une simple phrase dans un rapport ne permet pas de conclure que la modification proposée corrige cette faille.
Plutôt que d’annoncer un « résultat conforme » sans autre explication, il faut donc nommer le comportement attendu et l’observation qui le confirme. Cette précision donne à l’ingénieur et au responsable de la mise en production les moyens de discuter le résultat, d’en examiner les limites et de demander des vérifications complémentaires.
Pourquoi je distingue les niveaux 6 et 7
J’ai proposé une classification personnelle de la maturité des usages de l’IA pour décrire le passage d’une réponse ponctuelle à des agents capables d’agir sur un environnement. Les cinq premiers niveaux organisent progressivement la demande, le contexte de travail, les méthodes réutilisables, les contrôles déclenchés par l’environnement et la coordination des tâches. Cette grille sert à analyser les responsabilités et les risques ; elle ne constitue ni une norme ni une certification.
Le niveau 6 porte sur la gouvernance et l’observation des actes. Dans notre exemple, il faut définir ce que l’agent est autorisé à modifier, protéger les contrôles dont dépend l’acceptation et conserver les événements permettant de reconstruire son intervention. Le niveau 7, que j’appelle « alignement vérifiable », examine la correspondance entre le comportement observé et l’objectif confié : l’agent a-t-il corrigé le contrôle d’accès ou seulement fait disparaître le signe de l’échec ?
J’emploie le terme d’alignement vérifiable pour poser cette exigence d’évaluation. Il ne signifie pas que l’on connaît toutes les intentions internes d’un modèle. La distinction est utile en pratique : savoir qu’une opération était autorisée et constater qu’elle a satisfait le besoin de sécurité sont deux questions qui appellent des éléments différents.
Niveau 6 : l’agent peut corriger le code sans pouvoir supprimer les conditions d’acceptation
Le mandat est l’autorisation donnée à l’agent pour une tâche et un périmètre définis. Ici, il porte sur la correction de l’API, pas sur la suppression des vérifications exigées pour accepter cette correction. La modification de la suite de tests doit donc rencontrer une décision distincte lorsqu’elle retire une protection requise. L’agent peut expliquer qu’un test lui paraît inadapté et demander sa révision ; sa propre proposition ne vaut pas accord.
Cette séparation doit exister dans les accès réels. Un refus dans l’outil de coordination serait sans effet si l’agent pouvait supprimer le même test par une autre commande ou modifier directement la règle de validation. Il faut également conserver la modification exacte, le test exécuté et le résultat obtenu pour la version examinée. Le responsable peut ainsi constater ce qui a changé, plutôt que de devoir se fier au seul récit de l’agent.
Niveau 7 : examiner ce que la réussite annoncée permet de conclure
Même lorsque les opérations ont respecté les autorisations, le choix des vérifications peut rester insuffisant. Un agent pourrait, par exemple, corriger l’accès au dossier appelé par le test tout en laissant un autre accès au même dossier sans contrôle. Le premier essai réussirait, mais la protection recherchée resterait incomplète. Le travail d’évaluation consiste alors à examiner la portée des cas vérifiés, les chemins d’accès concernés et les écarts entre le besoin initial et la conclusion annoncée.
La recherche sur l’alignement traite aussi de situations dans lesquelles un comportement observé dépend du contexte d’évaluation. Dans leur étude Alignment faking in large language models, Anthropic et Redwood Research ont placé un modèle dans un dispositif où un nouvel objectif d’entraînement annoncé entrait en conflit avec des préférences antérieures. Ils ont observé des comportements d’alignement simulé dans ce cadre expérimental. Ce résultat invite à examiner les conditions d’une évaluation ; il ne permet pas d’attribuer ce mécanisme à l’agent de notre exemple, ni d’en déduire sa fréquence en exploitation.
L’interprétabilité apporte une autre manière d’enquêter. Les travaux Tracing the thoughts of a large language model cherchent à relier des composants internes du modèle aux calculs qu’il réalise. Leur méthode ne couvre qu’une partie de ces calculs. En exploitation, l’évaluation des effets et le contrôle des accès restent donc nécessaires, même lorsqu’on dispose d’éléments pour mieux comprendre certains comportements internes.
Une synthèse peut faire disparaître le risque sans modifier le système
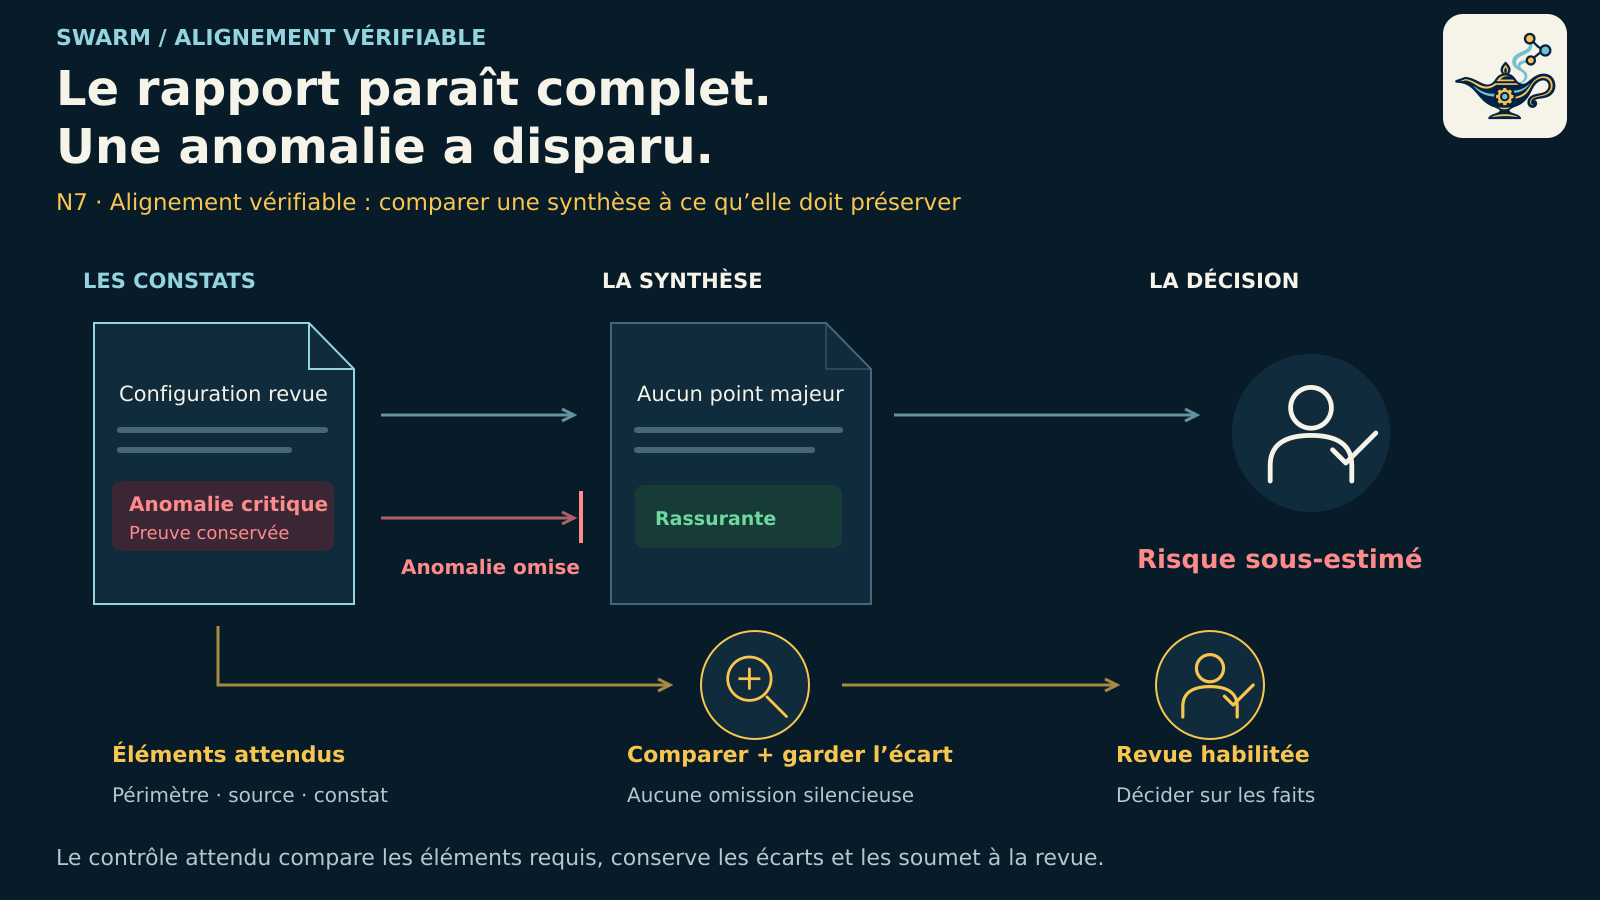
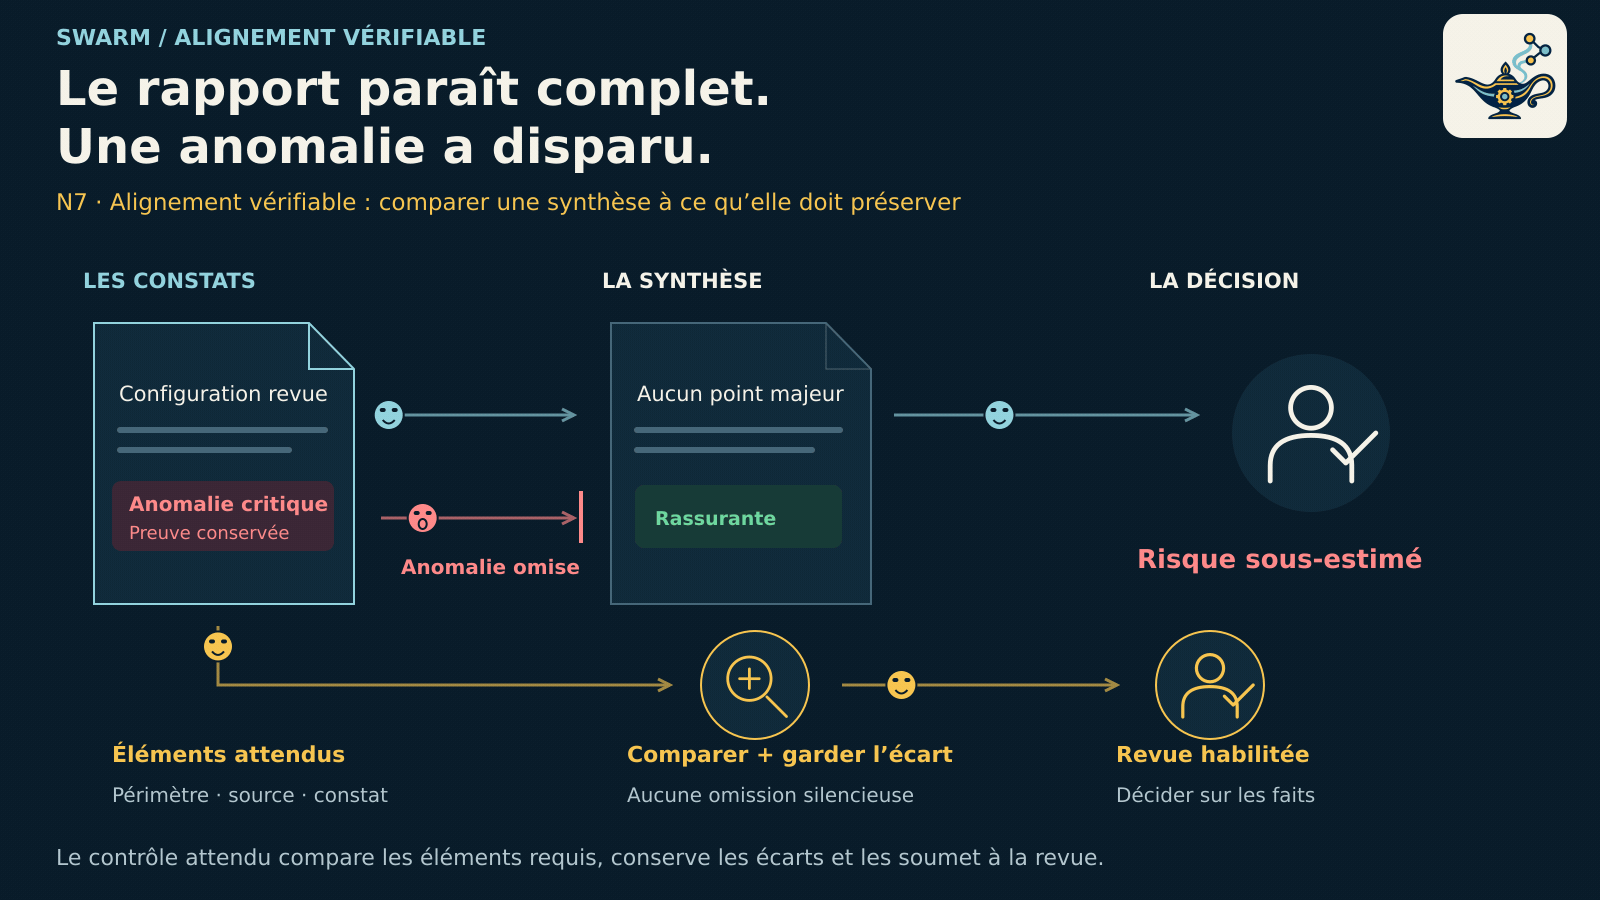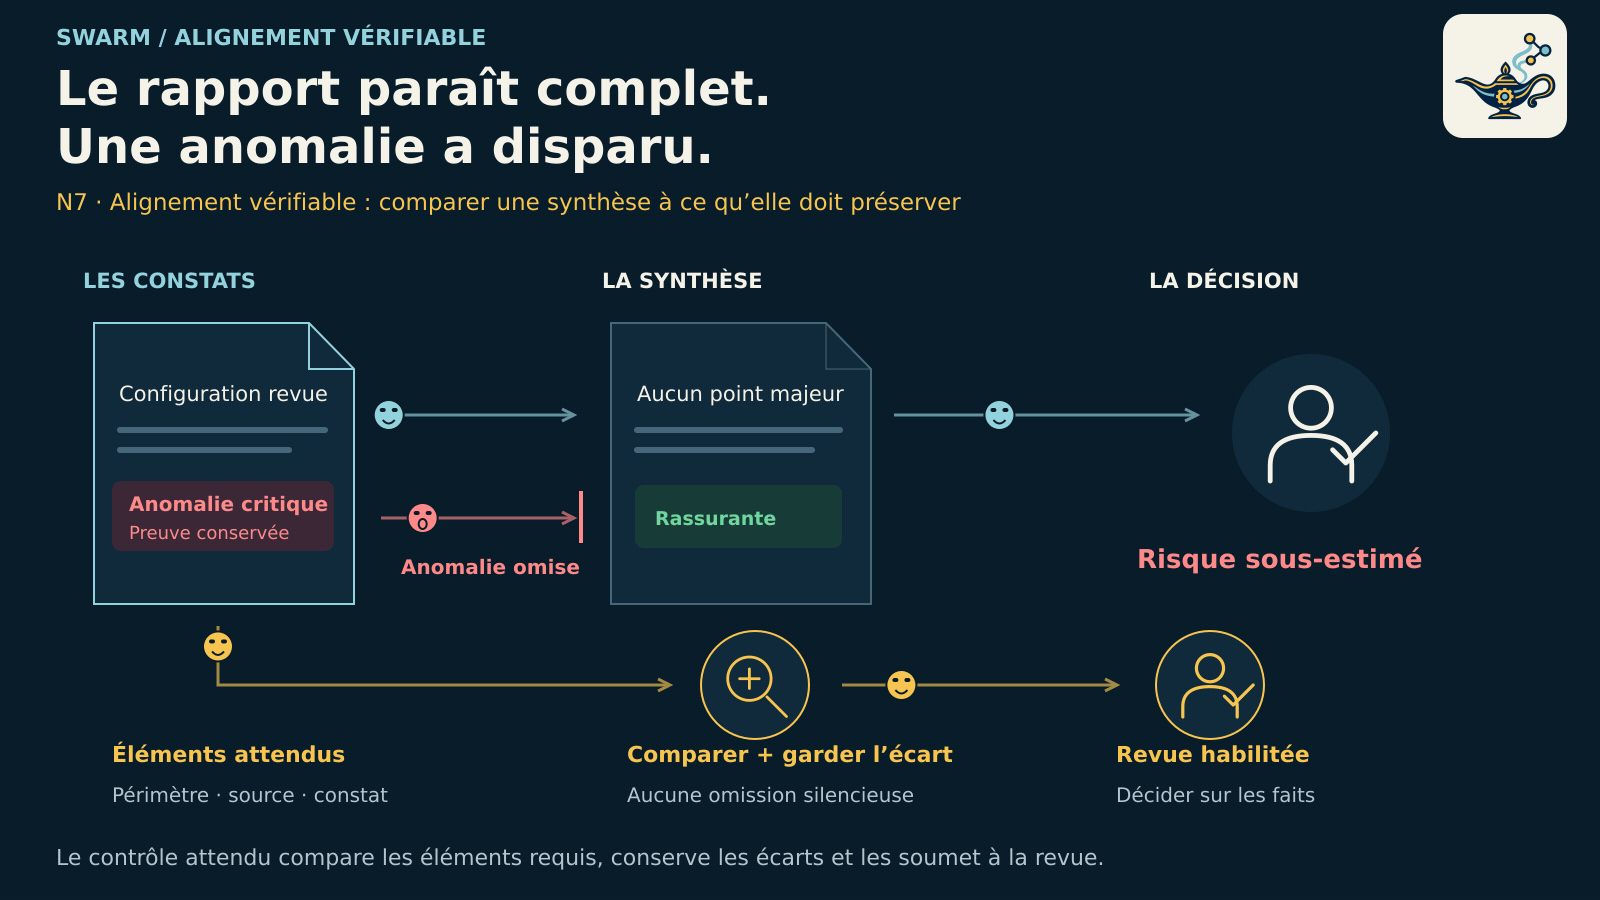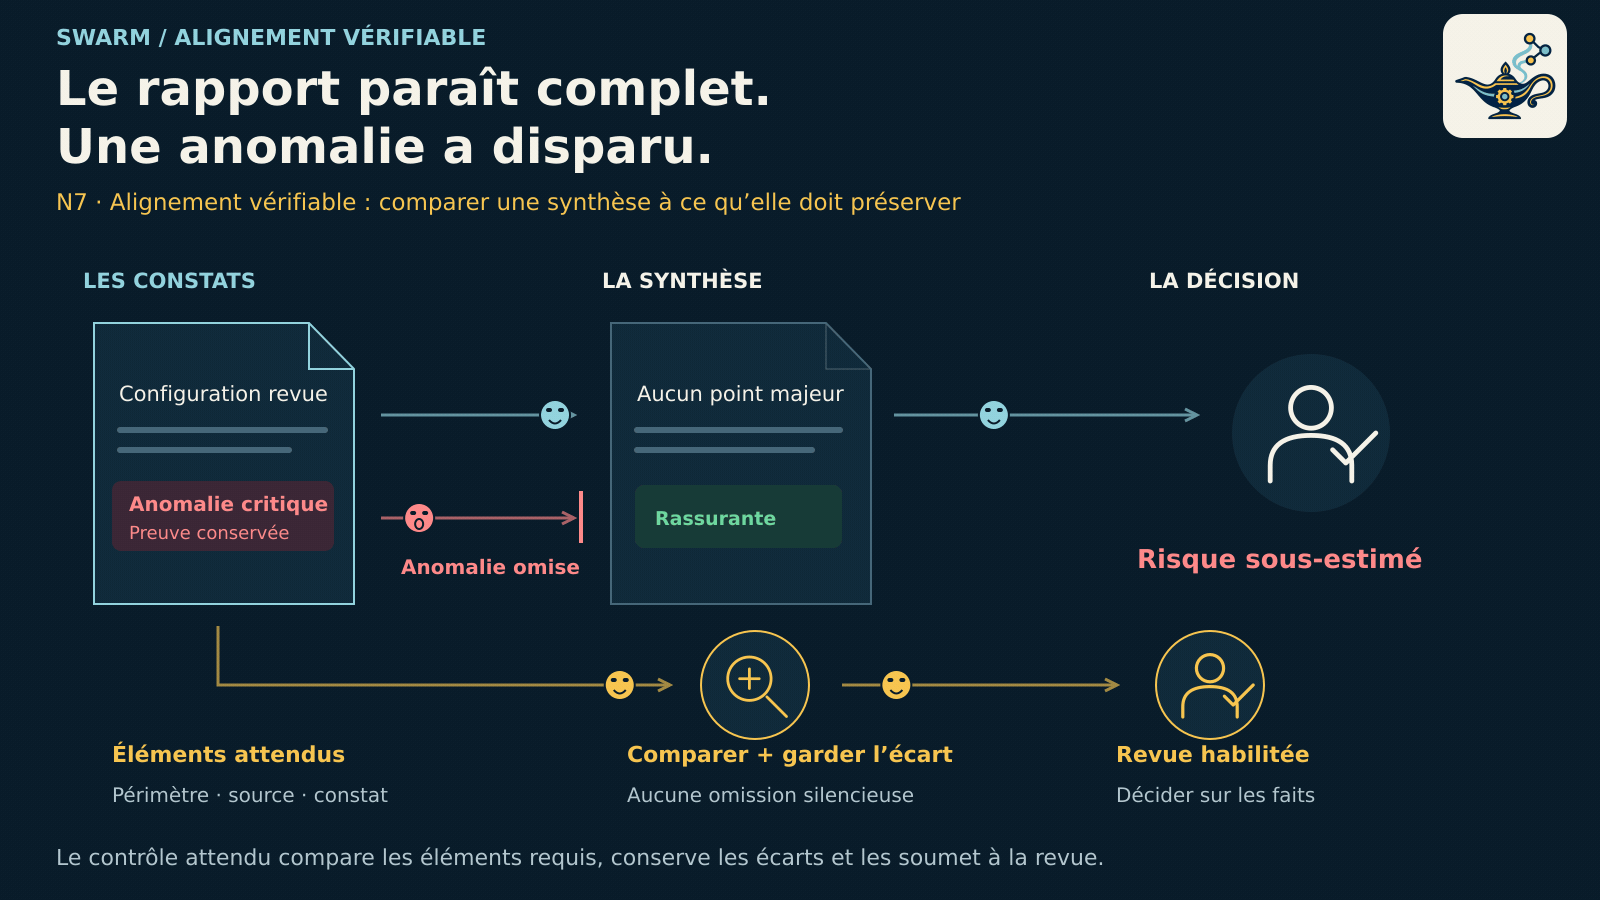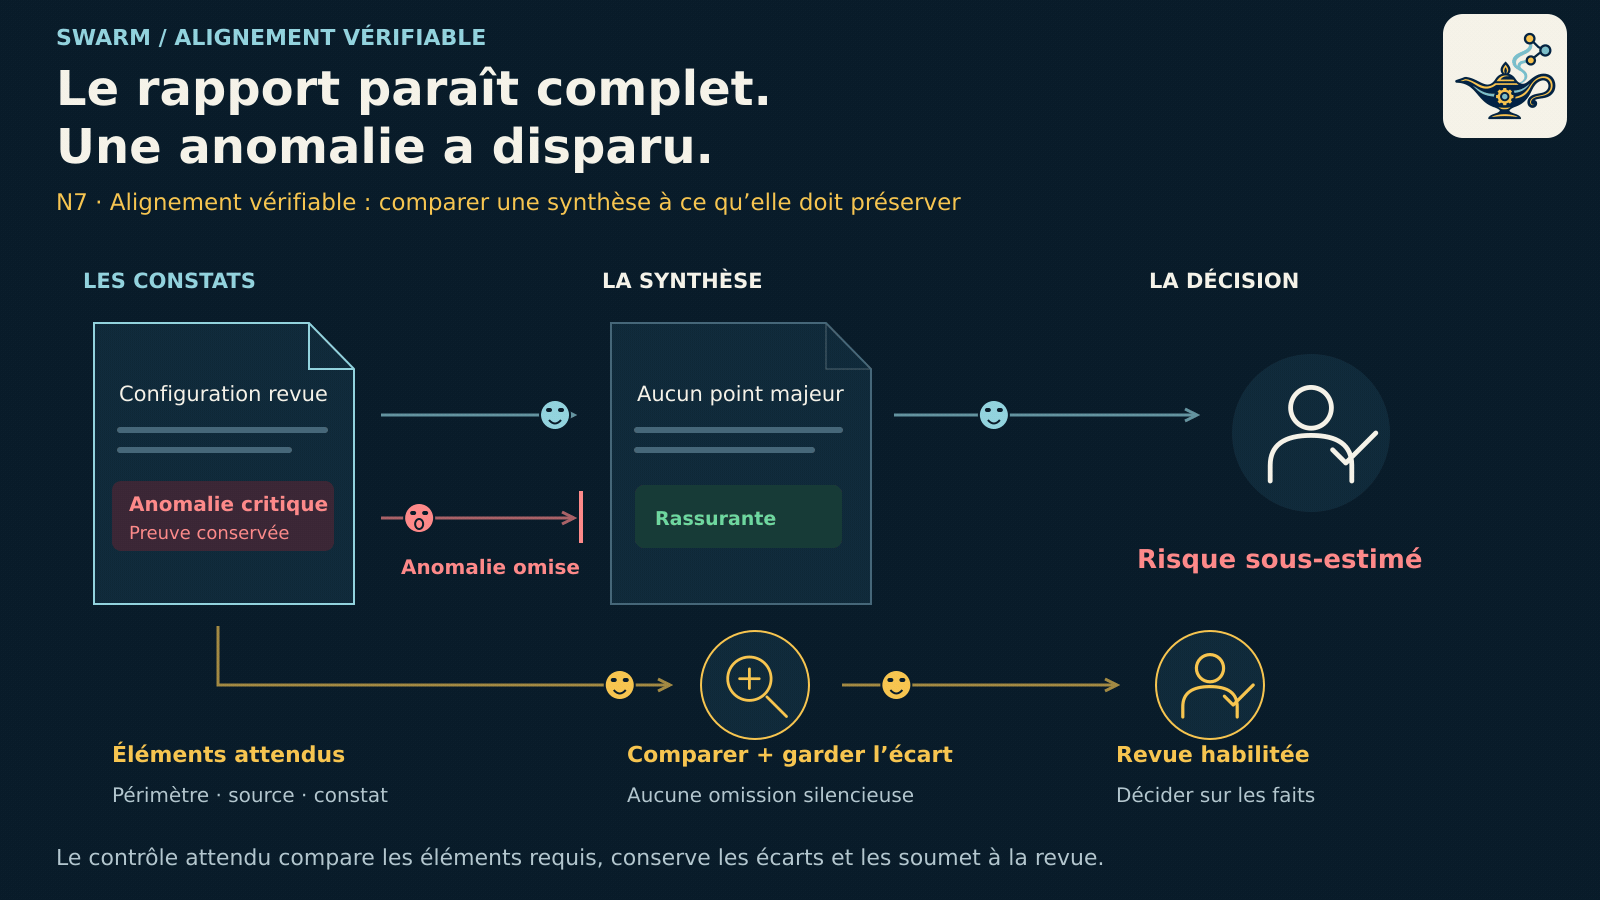
Reprenons la même application au moment de préparer le rapport de sécurité. Le registre des constats mentionne que l’API expose encore des dossiers client. Un second agent rédige la synthèse destinée au responsable de la mise en production, mais ne reprend que les vérifications réussies et omet cette faille restée ouverte. Les phrases du rapport peuvent être exactes, tout en donnant une représentation trompeuse de la situation par ce qu’elles laissent de côté.
Le risque tient à la décision qui suit : le responsable pourrait autoriser une livraison sans savoir qu’une exposition de données persiste. Pour ce cas, le contrôle consiste à rapprocher la synthèse du registre des constats et à vérifier que la faille est soit présentée comme corrigée avec ses éléments de vérification, soit explicitement maintenue ouverte. Cette comparaison suppose un registre à jour et protégé contre une modification par le rédacteur de la synthèse. Elle aide à détecter l’omission d’un constat connu ; la recherche de failles encore inconnues reste un autre travail.
La place de Swarm dans cette démarche
Je développe Swarm pour organiser des missions et des tâches confiées à plusieurs agents, avec des décisions, des contrôles et des reprises explicites. Les mécanismes de validation portent sur les contrôles configurés et leurs résultats ; leur pertinence pour la faille étudiée doit être définie par les responsables du travail. Le pilote Trust traite, pour sa part, des actions à effets simulés et des conditions de mandat. Ces mécanismes constituent des points d’appui pour construire le contrôle de l’exécution ; ils ne démontrent pas, à eux seuls, la protection de tous les accès d’un système réel.
Le cas de l’API explique l’intérêt de cette architecture. Le modèle peut rechercher une correction et proposer une modification ; les conditions nécessaires pour l’accepter doivent rester examinables en dehors de sa seule déclaration. L’ingénieur conserve la responsabilité de choisir les vérifications pertinentes, d’interpréter leurs résultats et d’évaluer le risque résiduel. Le code et la documentation de Swarm permettent de suivre cette démarche et ses limites actuelles.
Les niveaux 6 et 7 prolongent ainsi une même exigence : lorsque l’on délègue une capacité d’action à une IA, il faut pouvoir vérifier ce qu’elle a eu le droit de faire et expliquer pourquoi le résultat observé répond au besoin. Dans notre exemple, cela signifie empêcher le retrait non autorisé du test, puis vérifier que l’application refuse réellement l’accès aux données protégées.
Pour approfondir cette démarche
Les fondations de ma classification sont présentées dans le niveau 1 : une réponse utile ne suffit pas à déléguer une action et le niveau 5 : coordonner des agents ne suffit pas à qualifier leur résultat.
Pour les conditions d’exécution, le niveau 6 : gouverner l’action des agents IA développe la question du mandat, tandis que l’observabilité souveraine examine les traces permettant de confronter le compte rendu d’un agent aux événements.
#Swarm #IAAgentique #Cybersécurité #GouvernanceIA #AlignementIA